Bir analist yeni bir rapor için "aktif müşteri" sayısına ihtiyaç duyuyor. Veri ambarında bu adı taşıyan üç ayrı tablo var: biri pazarlamanın, biri finansın, biri iki yıl önce ayrılmış bir mühendisin yan projesi. Hangisi doğru? Kim güncelliyor? En son ne zaman yenilendi? Bu soruların cevabı çoğu kurumda bir Slack kanalında, birinin hafızasında ya da hiçbir yerde değil. Veri kataloğu tam olarak bu boşluğu doldurmak için var.
Veri Kataloğu Tam Olarak Ne Yapar?
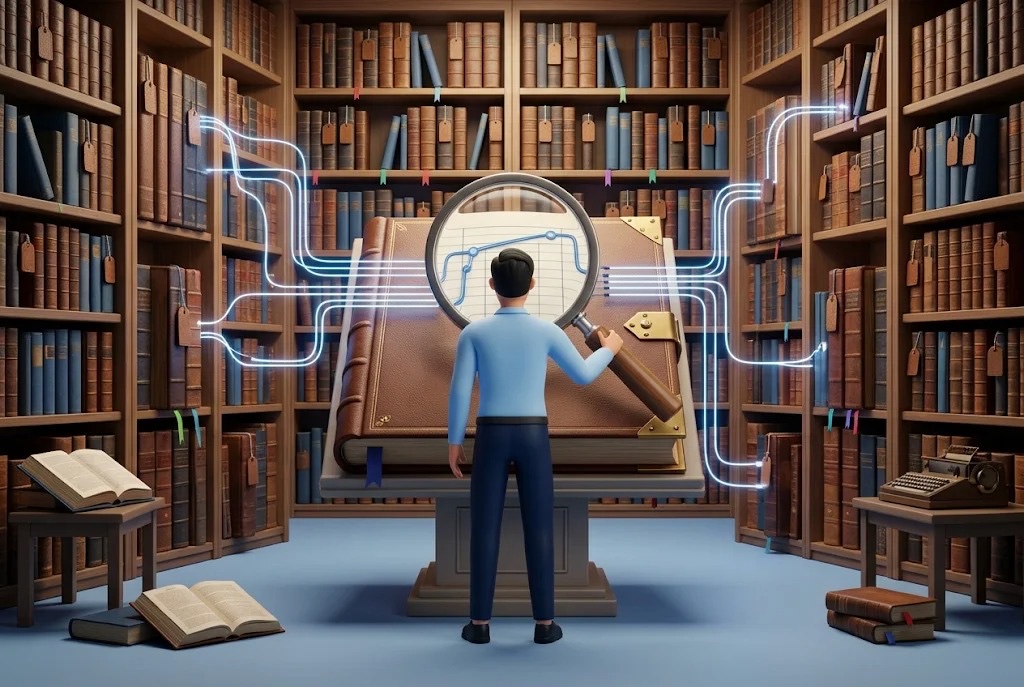
"Data catalog nedir" diye soranlara verdiğim en kısa cevap şu: kurumdaki veri varlıklarının aranabilir, açıklamalı ve sahipli bir envanteri. Kütüphane benzetmesi biraz eskimiş olsa da hâlâ işe yarıyor. Kitapların kendisi raflarda durur; katalog ise hangi kitabın nerede olduğunu, kimin yazdığını, hangi konuyu işlediğini söyler. Veri kataloğu da veriyi taşımaz ya da kopyalamaz. Tabloların, görünümlerin, dosyaların, dashboard’ların ve pipeline’ların hakkındaki bilgiyi, yani metadata’yı toplar ve bunu insanların anlayacağı bir arayüzde sunar.
İyi bir katalogda bir tabloya baktığınızda kolon adlarının yanında o kolonların iş anlamını, tablonun sahibini, güncellenme sıklığını, kalite kontrollerinin son sonucunu ve hangi raporların bu tabloya bağlı olduğunu görürsünüz. Kötü bir katalogda ise yalnızca şema dökümü vardır; bu da veri tabanının kendi bilgi şemasından pek farklı değildir.
Metadata’nın Üç Katmanı
Katalog projelerinin çoğu, hangi metadata’yı toplayacağını netleştirmeden başlar ve sonra kapsam her yöne dağılır. Sahada en çok işe yarayan ayrım şu üç katman oluyor:
- Teknik metadata: Şema, veri tipleri, bölümleme bilgisi, depolama konumu, boyut. Çoğu araç bunu otomatik tarayarak toplar; insan emeği gerektirmez.
- İş metadata’sı: Açıklamalar, iş sözlüğü terimleri, veri sahibi, hassasiyet sınıfı (örneğin kişisel veri içerip içermediği). Burada otomasyon yardımcı olur ama son sözü alan uzmanı söyler.
- Operasyonel metadata: Son güncellenme zamanı, kalite taramalarının sonuçları, kullanım sıklığı, hangi işlerin tabloyu okuyup yazdığı.
Teknik katman kolay kazanılır ve projeye hızlı bir başarı hissi verir. Asıl değer ise iş katmanında yatar; çünkü analistin "bu tablo neyi temsil ediyor?" sorusuna cevap veren odur. Operasyonel katman da güveni inşa eder: dün gece çalışmamış bir yüklemenin tablosunu kimse rapora koymak istemez.
Veri Keşfi ve Veri Soy Ağacı
Kataloğun en çok kullanılan iki yeteneği veri keşfi (data discovery) ve veri soy ağacı (data lineage). İkisi farklı sorulara cevap verir.
Veri keşfi "ihtiyacım olan veri nerede?" sorusunu çözer. Kullanıcı arama kutusuna "iade oranı" yazar ve ilgili tabloları, metrik tanımlarını, hatta bu konuda daha önce hazırlanmış raporları görür. Son dönemde birçok platform anlamsal aramayı da destekliyor; yani kullanıcının tam kolon adını bilmesi gerekmiyor. Bunun pratik etkisi, veri ekibine gelen "şu veri hangi tabloda?" taleplerinin belirgin biçimde azalması. Bu taleplerin her biri küçük görünür ama bir yılda biriktiğinde ciddi bir mühendislik zamanı eder.
Veri soy ağacı ise "bu veri nereden geldi ve neye dokunuyor?" sorusunu cevaplar. Kaynak sistemden başlayıp dönüşüm adımlarından geçerek son rapora kadar uzanan yolu gösterir. Kolon seviyesinde lineage sunan araçlarda, bir kaynak kolonun adını değiştirmeden önce hangi dashboard’ların kırılacağını görebilirsiniz. Ben bu özelliğin değerini en net, bir finans raporundaki tutarsızlığın kaynağını aramak için günlerce SQL okunan projelerde gördüm. Lineage olsaydı aynı iş birkaç saatte biterdi.
Kataloglar Neden Çoğu Zaman Terk Edilir?
Dürüst olmak gerekirse, birçok kurumda katalog kurulur, birkaç ay coşkuyla doldurulur, sonra kimse açmaz olur. Bunun nedenleri genellikle teknik değil, organizasyoneldir.
İlk neden sahipsizlik. Her varlığın bir sahibi yoksa açıklamalar eskir, eskiyen açıklamalara güven azalır, güven azalınca kullanım düşer. İkinci neden, kataloğun günlük iş akışından kopuk olması. Analist BigQuery konsolunda ya da BI aracında çalışıyorsa ve katalog ayrı bir sekmede duruyorsa, oraya gitmek için bir bahane gerekir. Üçüncüsü ise her şeyi aynı anda kataloglamaya çalışmak. Binlerce tabloyu tek seferde belgelemeye kalkışan ekipler genellikle hiçbirini düzgün belgeleyemez.
Çalışan yaklaşım daha mütevazı: en çok sorgulanan ve en kritik raporları besleyen birkaç düzine tabloyla başlamak, bunları gerçekten iyi belgelemek ve kullanıcıların bu farkı hissetmesini sağlamak.
Google Cloud Tarafında Durum: Data Catalog’dan Knowledge Catalog’a
Google Cloud kullanan ekipler için son iki yılda önemli bir değişiklik oldu. Eski Data Catalog hizmetinin arama ve kataloglama özellikleri 2025 başında kullanımdan kaldırılma sürecine girdi ve 1 Haziran 2026 itibarıyla sonlandırıldı. Yerini Dataplex çatısı altındaki birleşik katalog aldı. "Dataplex nedir" sorusuna bugün verilecek cevap da bu yüzden biraz değişti: ürün bir dönem Dataplex Universal Catalog adıyla anıldı, Nisan 2026’da adı Knowledge Catalog olarak güncellendi. API ve IAM adları ise aynı kaldı, bu da mevcut entegrasyonların kırılmadığı anlamına geliyor.
Bir not: BigQuery’de kolon seviyesi erişim için kullanılan policy tag’ler bu sonlandırmanın dışında tutuldu, ancak bunlar hâlâ Data Catalog API’sinin açık kalmasını gerektiriyor. Geçiş yaparken bu API’yi "nasılsa kapandı" diye devre dışı bırakmak, beklenmedik erişim sorunlarına yol açabilir.
Knowledge Catalog; BigQuery, AlloyDB, Spanner gibi kaynaklardan teknik metadata’yı otomatik toplar, doğal dil ile arama, kolon seviyesinde lineage, veri kalitesi taramaları, profilleme ve iş sözlüğü gibi yetenekleri tek çatı altında sunar. "Aspect" adı verilen yapılandırılmış metadata şablonlarıyla kendi iş bağlamınızı da varlıklara ekleyebilirsiniz.
Sıkça Sorulan Sorular
Veri kataloğu ile metadata yönetimi arasındaki fark nedir?
Metadata yönetimi, veri hakkındaki bilginin toplanması, standartlaştırılması ve güncel tutulmasına dair genel disiplindir. Veri kataloğu ise bu disiplinin kullanıcıya dönük yüzüdür: metadata’yı aranabilir ve anlaşılır hâle getiren araç. Yani katalog, metadata yönetimi olmadan içi boş kalır; metadata yönetimi de katalog olmadan çoğu zaman kimsenin görmediği bir arka ofis işi olarak kalır.
Veri kataloğu veri yönetişimine nasıl katkı sağlar?
Yönetişim politikaları kâğıt üzerinde kaldığı sürece işe yaramaz; katalog bu politikaları varlıkların üzerine işler. Hangi tablonun kişisel veri içerdiği, kimin sahibi olduğu, hangi kalite kurallarına tabi olduğu katalogda görünür hâle gelir. KVKK gibi düzenlemeler açısından kişisel verinin nerede tutulduğunu ve nereye aktığını göstermek de kolaylaşır; ancak somut uyum yükümlülükleriniz için bu bir hukuki tavsiye değildir, bir uzmana danışmanız gerekir.
Google Dataplex ne işe yarar?
Dataplex, Google Cloud’daki veriyi farklı depolama katmanlarında bulunsa bile tek noktadan keşfetmeye, kataloglamaya ve yönetmeye yarayan hizmet ailesidir. Katalog bileşeni bugün Knowledge Catalog adını taşıyor ve arama, lineage, veri kalitesi ile profilleme gibi yetenekleri bir arada sunuyor. Eski Data Catalog’u kullanan ekiplerin geçiş için hedefi de bu ürün.
İlk 90 Günde Kataloğu Nasıl Ayağa Kaldırmalı?
Katalog projesine araç seçimiyle değil, bir soru listesiyle başlamanızı öneririm. Analistlerinizin, veri mühendislerinizin ve uyum ekibinizin en sık sorduğu on soruyu toplayın; katalog bu sorulara cevap veremiyorsa doğru kurulmamış demektir. Ardından şu sırayı izlemek genellikle iyi sonuç verir:
- En kritik iki ya da üç raporu seçin ve bunları besleyen tabloları belirleyin.
- Bu tabloların her birine bir sahip atayın; sahibi olmayan varlığı kataloğa almayın.
- Teknik metadata’yı otomatik tarayın, iş açıklamalarını sahiplerle birlikte yazın.
- Lineage ve kalite taramalarını açın; kırmızı sinyalleri kullanıcıya görünür kılın.
- Kullanım verisine bakarak kapsamı genişletin.
Bu ilk dalga oturduğunda kapsamı büyütmek çok daha kolaylaşır, çünkü artık kurum içinde kataloğa güvenen bir kullanıcı kitlesi vardır. Google Cloud üzerinde veri ambarı ve yönetişim yapısını kurgulayan ekipler için Global IT, Knowledge Catalog geçişi ve veri platformu tasarımı konusunda Premier Partner deneyimiyle destek sunuyor.